耳コピでベースの音程を追いたいとき、好きな曲のドラムだけを聴いて手順を覚えたいとき、2ミックスから一つの楽器だけを取り出せると作業がずいぶん楽になる。手元のPCで動く音源分離の道具としていちばん名前を聞くのがDemucsで、1曲をボーカル・ドラム・ベース・その他の4つに分けてくれる。無料で、音声を外部のサービスに送らずに済むのもありがたい。
ただ、Demucsには学習済みのモデルが何種類もあり、名前もhtdemucs、htdemucs_ft、htdemucs_6sと似ていて紛らわしい。しかも元のリポジトリは更新が止まり、入手先が移っている。このメモでは、現行の3つのモデルについて、楽器ごとの分離精度、処理にかかる時間、分けたあとに何がどこへ残るかを整理しておく。数字は開発者が論文とリポジトリで公表している値だけを使い、最後に自分の曲で確かめる手順をまとめた。
元のリポジトリはアーカイブされ、開発者個人のフォークが本流になった
Demucsは、Meta(旧Facebook)の研究部門にいたAlexandre Défossezさんが中心になって開発した音源分離のソフトだ。長くfacebookresearchの名前でGitHubに置かれていたが、開発者がMetaを離れたため、このリポジトリは保守されなくなり、読み取り専用のアーカイブになっている。READMEの冒頭には、もう保守していないこと、開発者個人のアカウントにフォークを作ったことが書かれている。
いま本流として扱われているのは、そのフォークのadefossez/demucsだ。こちらのREADMEには、これが公式に保守されている版だと明記されている一方で、積極的には手を入れておらず、返事は遅く、新しい機能もしばらく無いとも書かれている。大きな改良は期待せず、動き続けるための修正が入る場所だと考えておくのがよさそうだ。
それでも、2026年7月11日には4.1.0が出た。2023年9月の4.0.1以来、3年近くぶりの更新になる。変更点は、使う側から見ると次の3つが大きい。
- 対応するPythonの下限が3.10に、PyTorchの下限が2.1に上がった
- 推論(分離)にtorchaudioを使わなくなり、音声の読み込みは別のライブラリと、それで読めない形式だけffmpegで行うようになった
- 学習済みモデルの置き場所が、従来のAmazonのストレージからHugging Faceに移った
2つ目の変更はとくにありがたい。これまでは新しいPyTorchやtorchaudioと組み合わせると音声の書き出しでつまずくことがあり、古い版に固定して使う人が多かった。4.1.0ではWAVの書き出しを自前で行うので、その心配がかなり減っている。ただしFLACで書き出すときだけはffmpegが必要になった。
入手は、pip install demucs でPyPIから入れるのが基本になる。READMEには、uvというツールを使って uvx demucs 曲名.mp3 と打てば、インストールの手順を飛ばしてそのまま分離を始められる方法も載っている。古い記事に出てくるfacebookresearchのリポジトリから直接入れる手順は、もう追いかけなくてよい。
htdemucsとhtdemucs_ftは、同じ学習データで作りが違う
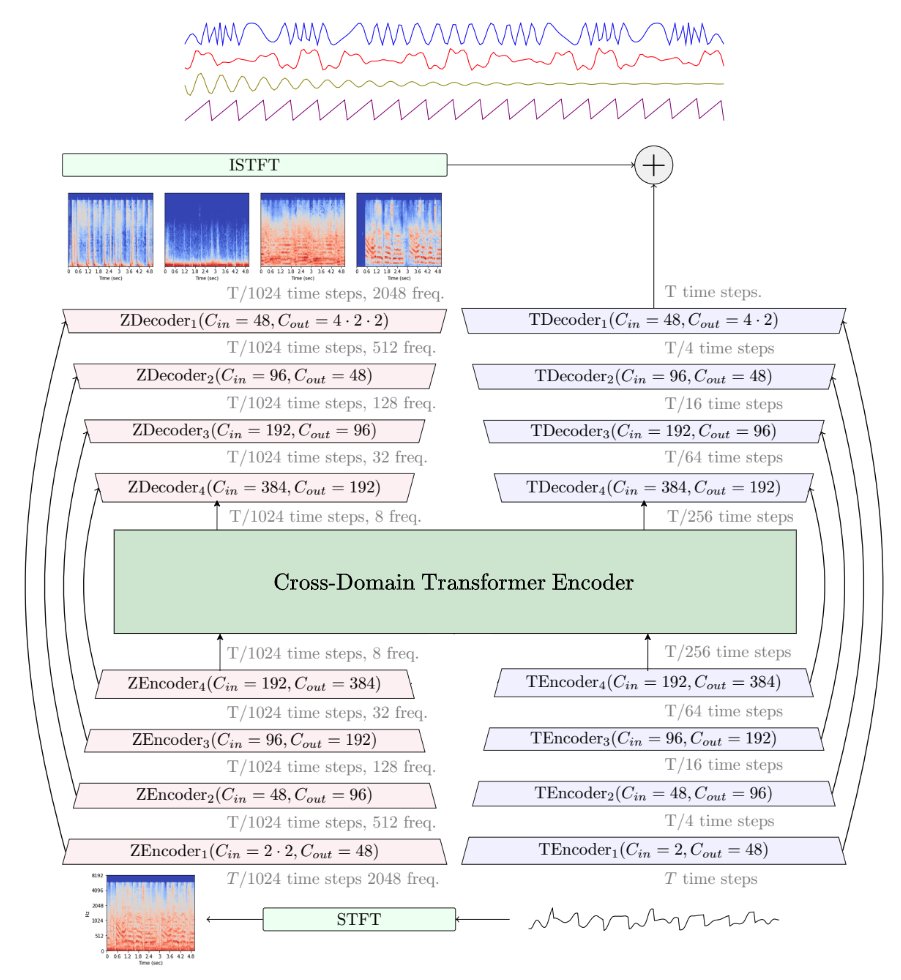
現行の第4世代は、Hybrid Transformer Demucsという構造をとっている。音を波形のまま扱う系統と、周波数ごとの強さに直したスペクトログラムで扱う系統を並べ、真ん中のTransformerで両方の情報を行き来させる作りだ。波形の系統は音の立ち上がりや位相に強く、スペクトログラムの系統は持続する音の高さや響きに強いので、両方を組み合わせて弱点を補い合っている。
この世代で配られているモデルは3つある。
| モデル | 分ける数 | 中身 | 処理時間 |
|---|---|---|---|
| htdemucs | 4(ボーカル・ドラム・ベース・その他) | 1つのモデルで4つを同時に出す。初期値 | 基準 |
| htdemucs_ft | 4 | htdemucsを楽器ごとに追加学習した4つのモデルの組 | 約4倍 |
| htdemucs_6s | 6(4つ+ギター・ピアノ) | htdemucsを6種類に広げた版 | 1モデル分 |
どれも学習に使ったのは、研究用の定番データセットであるMUSDB18-HQに、独自に集めた800曲を足したものだ。違いは作りにある。htdemucsは1つのモデルが4つの楽器をまとめて受け持つのに対し、htdemucs_ftはドラム担当、ベース担当、その他担当、ボーカル担当という4つのモデルを別々に仕上げ、それぞれが自分の担当の楽器だけを取り出す。4回分の計算をするので、時間がおよそ4倍かかる。
READMEでは、htdemucs_ftについて、時間は4倍かかるが少し良くなるかもしれない、という控えめな書き方をしている。この「少し」がどの程度なのかは、次の節の数字で見ておく。
楽器ごとの分離精度は、ベースとドラムが高く「その他」が低い
音源分離の精度は、SDR(信号対歪み比)という値で表すのが一般的だ。正解の楽器の音に対して、取り出した音にどれだけ余計なものが混ざっているかを示す値で、デシベルで表し、大きいほどきれいに分かれていることになる。目安として、1dB上がると混ざり込んだ余計な音のエネルギーがおよそ2割減ると考えるとつかみやすい。
開発者の論文には、MUSDB18-HQの評価用の50曲で測った、楽器ごとの値が載っている。配布されているhtdemucs_ftに当たるのが、追加学習まで済ませた版の行だ。
| 楽器 | htdemucs_ft相当 | 論文の最良版(配布なし) |
|---|---|---|
| ドラム | 10.08dB | 10.83dB |
| ベース | 10.39dB | 10.47dB |
| その他 | 6.32dB | 6.41dB |
| ボーカル | 9.20dB | 9.37dB |
| 平均 | 9.00dB | 9.20dB |
右の列は、Transformerの計算を間引いて長い範囲を見られるようにした版で、論文では最も良い値を出しているが、配布されているモデルの一覧には入っていない。手元で使えるのは左の列までだと考えておく。前の世代のHybrid Demucs(第3世代)は平均7.7dBだったので、世代が1つ進んで1dB以上良くなったことになる。
この表から読み取れることは2つある。ひとつは、ベースとドラムがいちばんきれいに抜けることだ。ベースは低い帯域にまとまっていて、ドラムは音の立ち上がりがはっきりしているので、どちらもほかの楽器と区別しやすい。耳コピでベースラインを追うなら、Demucsはかなり頼りになると思う。
もうひとつは、「その他」が4dB近く低いことだ。ギター、鍵盤、ストリングス、シンセなど、ボーカルとドラムとベース以外のすべてがここに入るので、取り出すべき音の中身が曲ごとにまったく違う。言い換えると、ほかの3つで取りこぼした音の受け皿にもなっている。
なお、ここ数年はDemucsとは別の方式の分離モデルも増えていて、BS-RoFormerのように同じ評価用の曲で平均9.8dB前後を出すものもある。数字の上ではDemucsはもう最先端ではないが、手軽に入れられて、ドラムとベースまで1回で分けられる道具としての使いやすさは変わらない。
残響とにじみは、どのステムに残るのか
数字は平均値なので、実際に分けた音で気になるのは、何がどこに残るかだ。ここは構造と学習データから考えると、傾向をかなり予想できる。
まず残響について。MUSDB18-HQの正解データは、各楽器をミックスに使った状態のトラックで、ボーカルの正解には、多くの場合そのボーカルに掛かったリバーブやディレイも含まれている。そのため、Demucsはボーカルの残響をボーカルの一部として取り出そうとする。ただ、残響の尾は音量が小さく、ほかの楽器の持続音と重なりやすいので、すべてを拾いきれない。拾いきれなかった分は「その他」に流れ込み、伴奏側を聴くと、歌の消えたところに薄い響きだけが漂って聞こえる。カラオケ用の伴奏を作るとき、いちばん気になりやすいのがこの部分だ。
次に、楽器どうしのにじみ。よく起きるのは、ハイハットやシンバルの細かい高音がボーカルに混じること、キックの低音とベースの境目があいまいになること、そしてハーモニーやコーラスの扱いだ。4ステムのモデルには「主旋律の歌」と「コーラス」を分ける考え方が無いので、重なった声はまとめてボーカルに入るか、楽器のように聴こえる部分だけが「その他」に回る。歌のパート割りを聴き取りたいときは、ボーカルのステムだけで判断しないほうがよい。
6ステムのhtdemucs_6sでは、「その他」からギターとピアノが独立する。READMEにはピアノの出来がまだ良くないと書かれていて、ピアノのステムにほかの楽器が混ざったり、ピアノの音が欠けたりすることは前提にしておいたほうがよい。ギターは比べればまともに分かれるが、歪んだギターとシンセのように音色が近いものは取り違えやすい。ギターとピアノが抜けた分、「その他」の中身は減るものの、残る音はさらに雑多になる。
最後に、分けた音に特有の質感がある。周波数の帯域ごとに音を振り分けるので、取りこぼしの多い区間では、水の中で鳴っているような、少しにじんだ響きになる。ステムを単独で聴くと気になるが、元のミックスに戻して音量を少し動かす程度なら目立たない。分けた音を素材としてそのまま使うより、耳コピや練習、リミックスの下準備に使うほうが向いている道具だと思う。
処理時間とメモリの見積もり
READMEには、GPUを使う場合は少なくとも3GBのビデオメモリが必要で、初期設定のままなら7GBほど使う、と書かれている。足りないときは -d cpu を付ければCPUだけで動き、その場合の処理時間は曲の長さのおよそ1.5倍が目安だという。4分の曲なら6分ほどになる。htdemucs_ftはこれがさらに4倍になるので、CPUだけだと1曲に20分以上かかる計算になる。
精度を少し上げる方法として、--shifts という設定がある。入力の音を少しずつずらして何回か分離し、その結果を平均する方法で、回数を増やすほど細かな誤差が打ち消し合う。ただし回数の分だけ時間が倍々に増えるので、READMEはGPUが無いなら使わないよう勧めている。htdemucs_ftに --shifts を重ねると時間が掛け算で増えるので、どちらか一方から試すのが現実的だ。
もう一つ覚えておきたいのが、--segment の上限だ。Demucsは曲を短い区間に区切って処理していて、区間を短くすると使うメモリが減る。ただ、第4世代のモデルは学習したときの長さより長い区間を扱えず、上限は7.8秒になっている。ビデオメモリが少ないGPUで動かすときは、この範囲で値を下げることになる。
使う場面に合わせた選び方を、ざっとまとめておく。
- ボーカルだけを抜きたい:
--two-stems=vocalsを付けると、歌と、それ以外の伴奏の2つだけを書き出す - ベースやドラムの耳コピ: まずhtdemucs、聴き取りにくい箇所があればhtdemucs_ftで分け直す
- ギターやピアノを独立させたい: htdemucs_6sを使い、ピアノの結果は参考程度にとどめる
- 書き出しの形式: 初期値は16ビットのWAVで、
--int24や--float32を付けると後から音量を動かしても劣化しにくい
自分の曲で確かめる手順
公表されている数字は、評価用の50曲で測った平均だ。ジャンルや録音の仕方が違えば、結果は大きく変わる。自分がよく聴く曲で確かめるときは、次の順番で進めると違いが分かりやすい。
- 歌の残響が深いバラード、音数の多いロック、打ち込み中心の曲を1曲ずつ選び、30秒ほどの区間を切り出しておく。
- 同じ区間を、htdemucs、htdemucs_ft、htdemucs_6sの3つで分け、それぞれの処理時間を控える。
- ボーカルのステムでは、ハイハットの混じり方と、歌が止まった直後の残響の消え方を聴き比べる。
- 伴奏側(その他)では、歌の残響がどれだけ残っているかを聴く。ヘッドホンで音量を少し上げると分かりやすい。
- ベースのステムでは、キックの低音がどれだけ混ざっているかを、ベースが休んでいる小節で確かめる。
分けた4つのステムを足し合わせると、元のミックスにかなり近い音に戻る。ある楽器の取りこぼしは、ほかのどこかに必ず残っているということでもある。どのステムに何がにじんでいるかを一度確かめておくと、ボーカルの残響が気になるなら伴奏をhtdemucs_ftで作り直す、ベースの聴き取りだけならhtdemucsで十分、というように、曲ごとにモデルを選ぶ判断が早くなると思う。
関連記事
- 16bit化のディザを3通りで検証、ノイズシェーピングは総量で12dB増えて耳では9dB減る
- ミックス独学の1か月、同じ曲でEQ・コンプ・リバーブを1週ずつ
- OllamaのVRAM目安は「パラメータ数×0.6GB」から、制作PCで7Bから70Bまでを見積もる
- 明日の夜もウイスキー・カルチャーの記事やDTM理論の記事を公開予定です → note はこちら