このブログでは、記事に載せる写真を取り込むたびに、保存したファイルが出典の画像と同じものかを機械的に確かめている。出典から画像を取り直し、手元のファイルと並べて比べるのだが、保存のときに縮小と再圧縮をかけているので、ファイルの中身は1バイト単位ではまず一致しない。そこで使っているのが、画像の見た目から短い数字を作る「知覚ハッシュ」だ。検査のスクリプトには64ビットのdHashが入っていて、2つのハッシュで食い違うビットが10個以下なら同じ画像とみなしている。
この「10」という数字は、目安として決めたもので、どこまで加工に耐え、どこから別の画像を取り違えるのかをきちんと測ったことはなかった。そこで、Pythonでよく使われる知覚ハッシュの実装を並べ、写真1枚にさまざまな加工をかけたときの距離と、手元にある画像同士を総当たりで比べたときの距離を記録しておくことにした。使ったのはPython 3.12.10、ImageHash 4.3.2、Pillow 13.0.0、NumPy 2.5.4、SciPy 1.18.1で、作業用の仮想環境にまとめて入れている。
ファイルのハッシュと、見た目のハッシュ
MD5やSHA-256のようなハッシュは、入力が1ビットでも変われば出力がまったく別の値になるように作られている。改ざんを見つけるにはこの性質が欠かせないが、画像の比較には向かない。JPEGで保存し直しただけ、幅を半分にしただけでも、ハッシュ値は似ても似つかない値になり、「同じ写真かどうか」という問いには答えてくれない。
知覚ハッシュは、その逆を狙っている。画像を小さく縮めて細部を捨て、明るさの大まかな並びだけから数十ビットの値を作るので、人の目に同じに見える画像なら、ほぼ同じビット列になる。2つの値がどれだけ違うかは、食い違うビットの数、つまりハミング距離で測る。64ビットなら距離は0から64までで、0なら見た目がほぼ同じ、32前後なら無関係な画像同士と同じくらい離れている、と読む。
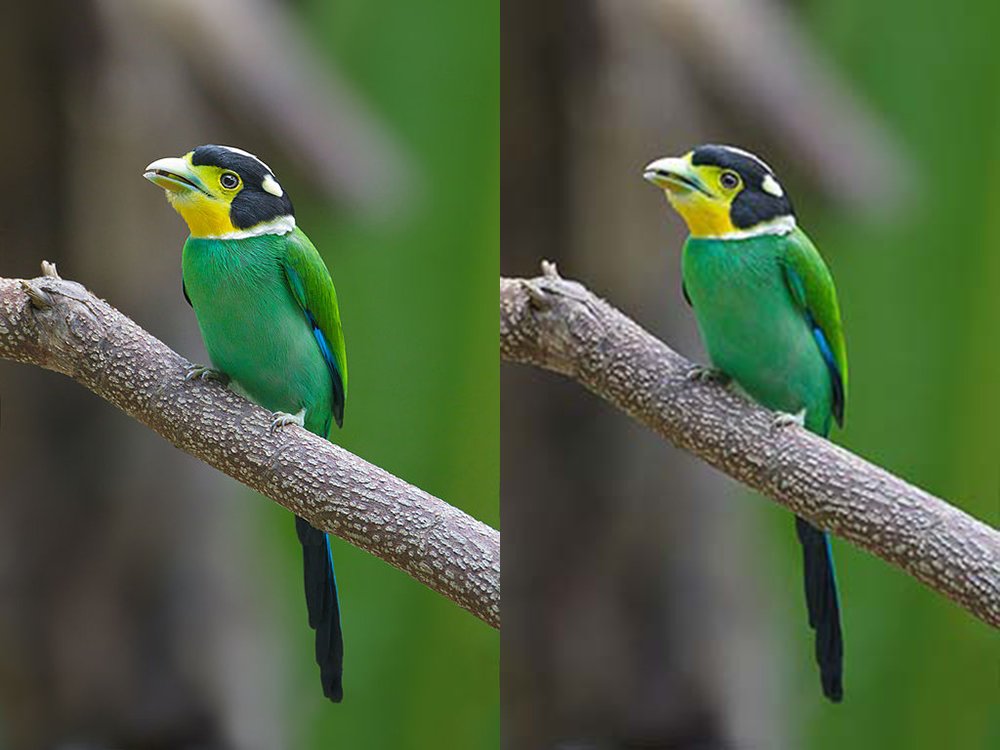
左の図は、1枚の鳥の写真を左右に並べ、右側だけ強く圧縮したものだ。この画像を真ん中で2つに切って比べると、aHash・dHash・pHashのいずれも距離は0、このブログの検査に入っているdHashでも1だった。背景のぼけた緑がくすみ、羽の色の境目が粗くなっていても、明るさの並びは変わっていないということだ。ファイルのハッシュが改ざんの有無を問うのに対し、知覚ハッシュは「人が見て同じ絵か」を問う道具だと考えると分かりやすい。
aHashとdHashは、8×8の明るさを並べるだけ
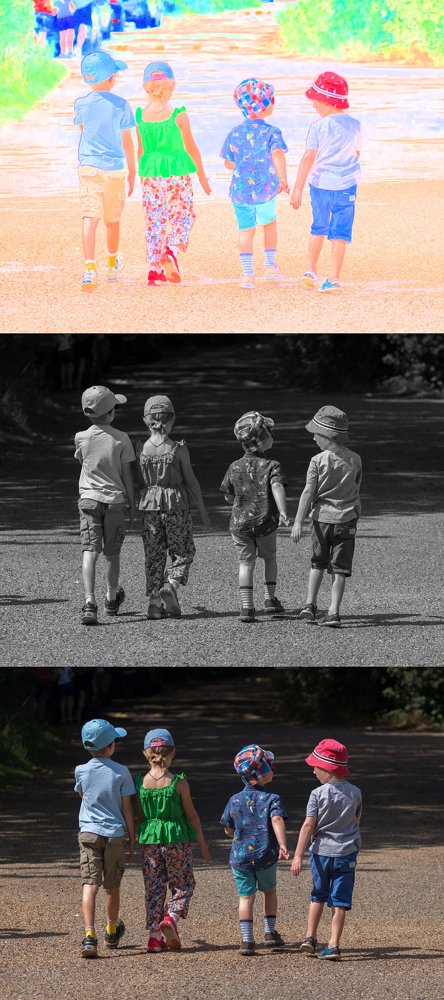
ImageHashに入っている代表的な3種類は、どれも最初にカラー画像をグレースケールに変える。Pillowでconvert("L")を呼ぶと、赤・緑・青の値に1000分の299、587、114を掛けて足した値が明るさになる。緑の重みが大きいのは、人の目が緑の明るさに敏感だからだ。色の違いはここで捨てられるので、写真をモノクロにしても3種類とも距離は0のままだった。
aHash(平均ハッシュ)は、いちばん素直な作り方をしている。画像を8×8の64画素まで縮め、64個の明るさの平均を出し、各画素が平均より明るければ1、暗ければ0とする。64画素を左上から順に並べれば、そのまま64ビットの値になる。計算は軽いが、画像全体の明暗の配置しか見ていないので、白い背景の真ん中に暗い物が立っている写真は、写っている物が何であれ似た値になりやすい。
dHash(差分ハッシュ)は、横に9画素、縦に8画素まで縮め、各行で隣り合う画素の明るさを比べる。1行に比べる組が8つ、8行で64ビットになる。平均と比べるのではなく、隣との差の向きを記録するので、画像全体が明るくなったり暗くなったりしても、差の向きはあまり変わらない。このブログの検査に入っているのもこの方式で、Pillowだけで書ける短さも選んだ理由だった。
from PIL import Image

def dhash(im):
    g = im.convert("L").resize((9, 8))
    px = list(g.get_flattened_data())
    return sum(1 << i for i in range(64)
               if px[(i // 8) * 9 + i % 8] > px[(i // 8) * 9 + i % 8 + 1])

def distance(a, b):
    return bin(dhash(a) ^ dhash(b)).count("1")
2つの値の排他的論理和を取ると、食い違うビットだけが1になる。その1の数を数えればハミング距離だ。aHashとpHashは2011年、dHashは2013年に、画像の解析を仕事にしているニール・クラウェッツが自身のブログで紹介した方式で、ImageHashの関数の説明にもその記事が挙がっている。
pHashは32×32に縮めてから、周波数の低い成分を見る
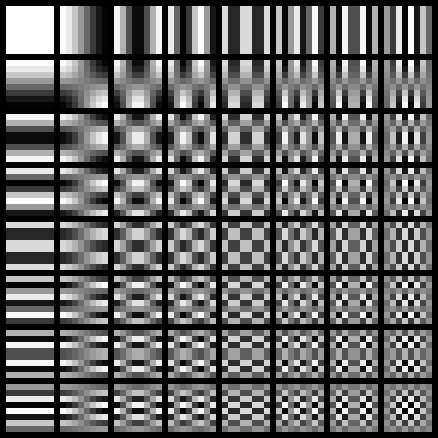
pHashは、画像を一度周波数の成分に分解してから判定する。ImageHashのphashは、まず画像を32×32まで縮めてグレースケールにし、縦と横に1回ずつ離散コサイン変換(DCT)をかける。DCTは、画像を左の図のような縞模様の重ね合わせとして表し、それぞれの模様がどれだけ含まれているかを数字にする変換で、JPEG圧縮の中でも使われている。左上ほどゆるやかな明暗の変化、右下ほど細かい模様に当たる。
pHashが残すのは、32×32の結果のうち左上の8×8、つまり周波数の低い64個の成分だけだ。細かい模様はノイズや圧縮のむらに左右されやすいので捨て、画像の骨格に当たる粗い明暗の分布だけで判定する。64個の値の中央値より大きければ1、そうでなければ0としてビットを並べる。ソースを読むと、中央値を求める範囲には画像全体の平均の明るさを表す左上の1個も含まれていた。平均値で比べるphash_simpleという別の関数もあり、こちらは左上の1列目を除いた8×8を平均と比べる。
ほかにも、DCTの代わりにウェーブレット変換を使うwhash、色の分布を見るcolorhash、画像を領域に分けて部分ごとにハッシュを取るcrop_resistant_hashがある。いずれも結果はImageHashという型で返り、2つを引き算するとハミング距離が整数で返ってくる。
import imagehash
from PIL import Image

a = Image.open("a.jpg")
b = Image.open("b.jpg")
print(imagehash.phash(a) - imagehash.phash(b))   # 0〜64
1枚あたりの計算時間も測った。手元の画像549枚を読み込み済みの状態で、aHashとdHashが1枚あたり約3.4ミリ秒、pHashが約5.0ミリ秒だった。大半は元の大きさから縮小する処理にかかっていて、DCTの分はわずかだ。数万枚程度なら、どれを選んでも速度で困ることはないと思う。
写真1枚を14通りに加工して、距離を測る
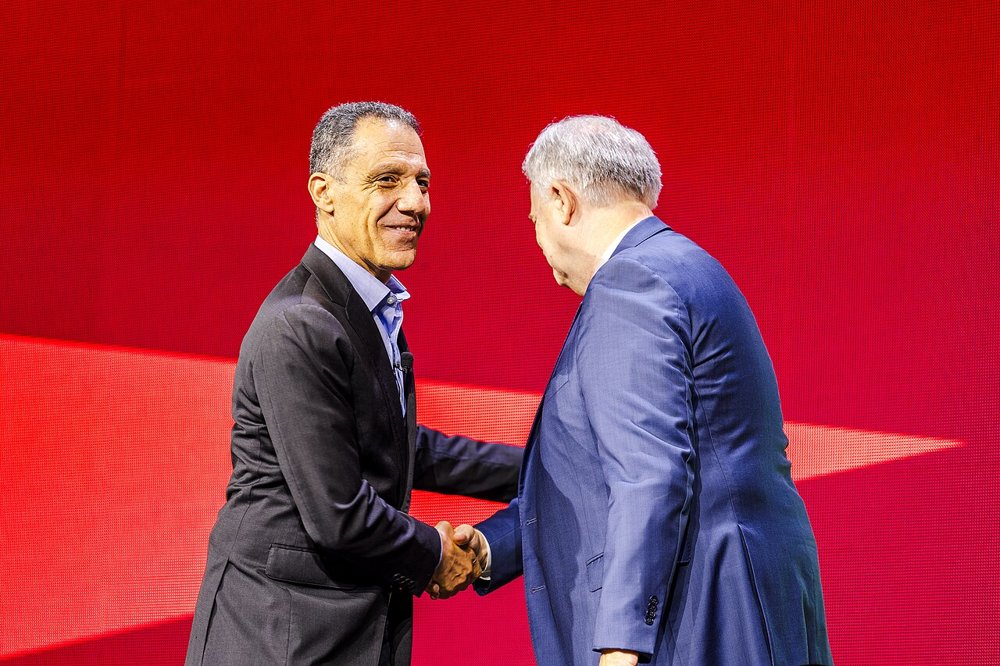
元にしたのは、右の幅1000画素の写真だ。これに縮小、再圧縮、明るさとコントラストの変更、トリミング、回転、左右反転などを1つずつかけ、元の写真とのハミング距離を4つのハッシュで測った。「ブログ」の列は、このブログの検査に入っているPillowだけのdHashで、ImageHashのdHashとは縮小に使うフィルターが違う。ImageHashはランチョス、Pillowのresizeは既定でバイキュービックを使う。
| 加工 | aHash | dHash | pHash | wHash | ブログのdHash |
|---|---|---|---|---|---|
| 幅を50%に縮小 | 0 | 0 | 0 | 0 | 1 |
| 幅を10%に縮小 | 0 | 0 | 0 | 0 | 2 |
| JPEG 品質30で保存 | 0 | 0 | 2 | 0 | 3 |
| JPEG 品質5で保存 | 1 | 5 | 4 | 2 | 4 |
| 明るさを30%上げる | 1 | 3 | 2 | 0 | 3 |
| コントラストを40%下げる | 0 | 1 | 2 | 0 | 3 |
| グレースケール | 0 | 0 | 0 | 0 | 0 |
| 縦横の比を16:9に引き伸ばす | 0 | 0 | 2 | 0 | 0 |
| 右下に白い四角を置く | 7 | 3 | 12 | 6 | 3 |
| 右端を5%切る | 3 | 9 | 10 | 2 | 9 |
| 3度回転 | 2 | 6 | 8 | 4 | 9 |
| 四辺を10%ずつ切る | 7 | 24 | 16 | 10 | 20 |
| 10度回転 | 8 | 15 | 14 | 14 | 17 |
| 左右反転 | 30 | 26 | 32 | 24 | 25 |
縮小、再圧縮、明るさの変更、モノクロ化には、どのハッシュもよく耐えている。幅を100画素まで縮めても距離は0か2で、JPEGの品質を5まで落とし、ブロック状のむらが目に見えるほど崩しても5以下に収まった。比率を変えて横に引き伸ばしても、もともと正方形に縮めて計算するので、ほとんど影響がない。保存のたびに縮小と再圧縮をかける、このブログの使い方とは相性が良いと思う。
弱いのは、絵の位置が動く加工だ。右端を5%切っただけでdHashとpHashは9から10まで動き、四辺を10%ずつ切るとdHashは24まで離れた。回転も3度で6から9、10度になると14から17まで行く。左右反転は24から32で、無関係な写真同士とほとんど変わらない。どの方式も、縮めた画像の決まった位置にある明るさを比べているので、位置がずれればビットもずれる。トリミングされた転載画像まで見つけたいなら、crop_resistant_hashのように領域ごとに比べる方法を考える必要がある。
意外だったのは、右下に白い四角を置いた加工だ。写真の面積の3%ほどを隠しただけなのに、pHashは12まで動いた。青いスーツの裾と赤い背景にまたがる位置に、まわりより明るい面ができ、粗い周波数成分の大小関係がいくつか入れ替わったのだと思う。透かしやロゴを入れた画像を同じものとみなしたい場合、pHashでしきい値10は少し厳しい。
手元の画像549枚を総当たりで比べる
加工への強さだけでなく、別の画像を誤って同じと判定しないかも確かめておきたい。このブログのstatic/imagesにある写真やパッケージ画像のうち、OGP用の画像を除いた549枚を読み込み、すべての組み合わせ15万426組について距離を出した。このうち31組は、同じ写真を複数の記事で使い回しているバイト単位で同一のファイルだ。
| 距離 | aHash | dHash | pHash |
|---|---|---|---|
| 0 | 46組 | 38組 | 44組 |
| 1〜5 | 100組 | 14組 | 0組 |
| 6〜10 | 750組 | 98組 | 5組 |
| 11〜15 | 2,855組 | 338組 | 20組 |
| 16以上 | 14万6,675組 | 14万9,938組 | 15万357組 |
3つとも、距離の中央値はちょうど32だった。無関係な画像同士なら、64ビットのうち半分が食い違う。偏りのない値が出ている、ということでもある。差が出るのは距離の小さい側で、aHashは距離10以下に896組、dHashは150組、pHashは49組が入った。距離0の組から同一ファイルの31組を除くと、残りの多くは同じ写真を別の大きさで保存し直したもので、これは見つかってほしい組だ。残りは、このあと触れる白い背景の商品画像と単色の画像だった。
取り違えが起きていたのは、白い背景の真ん中に商品が1つだけ立っている画像だった。同じ炭酸水メーカーの、ラベルの色だけが違う2本のペットボトルは、aHashで0、dHashで1、ブログのdHashでも1になった。ボトルの形と置き方が同じなので、明るさの並びではほとんど区別がつかない。pHashだけは16まで離れ、別の画像だと判定できた。黒いコンデンサーマイクと、白い磁器の徳利という、色も形も違う2枚がaHashで0になった組もあった。どちらも白い背景の中央に縦長の物が立っているだけで、平均との大小だけを見るaHashには同じ形に見えてしまう。
もう1つ気づいたのは、単色で塗っただけの画像の扱いだ。フォルダには記事で使っていない単色の画像が何枚か残っていて、オレンジ、青、緑と色が違っても、3つのハッシュはすべて同じ値になった。明るさに起伏が無ければ、平均と比べても隣と比べても、ビットの決まり方に違いが出ない。知覚ハッシュは「同じ形をしているか」は答えられても、「何の画像か」は答えられない、ということがよく分かる。
このブログの検査は、しきい値10のままでよいか
総当たりの結果を、このブログの検査に入っているdHashでも数え直した。同一ファイルを除いた組のうち、距離10以下は219組で、ImageHashのdHashの119組より多かった。同じ9×8の比較でも、縮小のフィルターが違うだけで、白い背景の画像の微妙な明暗の差がビットに出たり出なかったりするのだと思う。15万組のうち0.15%ほどなので、検索のように「似た画像を全部集める」使い方なら、しきい値を下げるかpHashを併用したくなる数字だ。
ただ、検査の使い方は検索とは違う。比べる相手は総当たりの誰かではなく、記録してある出典の1枚だけだ。出典と違う画像に差し替わっていれば、ほとんどの場合は距離が30前後に離れるので、10で十分に見分けられる。一方で、白い背景の商品写真を同じメーカーの別商品とすり替えた場合は、dHashだけでは見逃す可能性がある。この表を見る限り、pHashも合わせて計算し、どちらかが10を超えたら止める、という形にしておくのが手堅いと感じた。1枚あたりの計算は数ミリ秒なので、負担はほとんど増えない。
知覚ハッシュは、実際の大きな仕組みでも使われてきた。ファリドとマイクロソフトが2009年に作ったPhotoDNAは、児童の性的虐待画像の拡散を止めるために、既知の画像と見た目が同じものを見つける技術として各社に提供されている。フェイスブックは2019年に256ビットの写真用ハッシュPDQを公開した。アップルが2021年に発表したNeuralHashでは、公開から間もなく、まったく別の画像に同じハッシュを持たせる例が作られている。ハッシュが短く、見た目だけで決まる以上、狙って衝突させることは難しくない。今回の549枚の中にも、狙ってもいないのに衝突した組があった。
今回の検証で、知覚ハッシュの性格はかなりはっきりした。縮小と再圧縮には強く、位置の変化と左右反転には弱い。白い背景の単純な構図ではaHashとdHashが取り違えやすく、pHashはそこに強い代わりに、一部を隠す加工で大きく動く。どれか1つで万能というより、見たい変化に合わせて選び、必要なら2つを重ねて使うものだと思う。検査スクリプトにpHashを足すかどうかは、次に手を入れるときの課題としてここに残しておく。