打ち合わせの録音や、歌詞を口で吹き込んだボイスメモを文字にしたいとき、手元のPCで動くWhisperは便利な道具だ。音声を外部のサービスに送らずに済むので、未発表の曲の話をしている録音でも気にせず流し込める。ただ、使い始めるとすぐに迷うのがモデルの大きさだ。tinyからlargeまで6段階あり、さらにlarge-v3-turboという軽量版もある。動かす実装もOpenAI本家のほかにfaster-whisperとwhisper.cppがあって、組み合わせは思った以上に多い。
このメモでは、日本語で使う前提に絞って、モデルの大きさごとの文字誤り率、必要なメモリ、処理の速さを一つの表にまとめ直した。数字はOpenAIのリポジトリと、各実装・各モデルの配布元が公表している値だけを使っている。自分の録音で回す前に当たりをつけておけば、試す組み合わせを2つか3つに絞れる。最後に、自分の音声で確かめるときの手順も書き残しておく。
6つのサイズと、それぞれに必要なVRAM
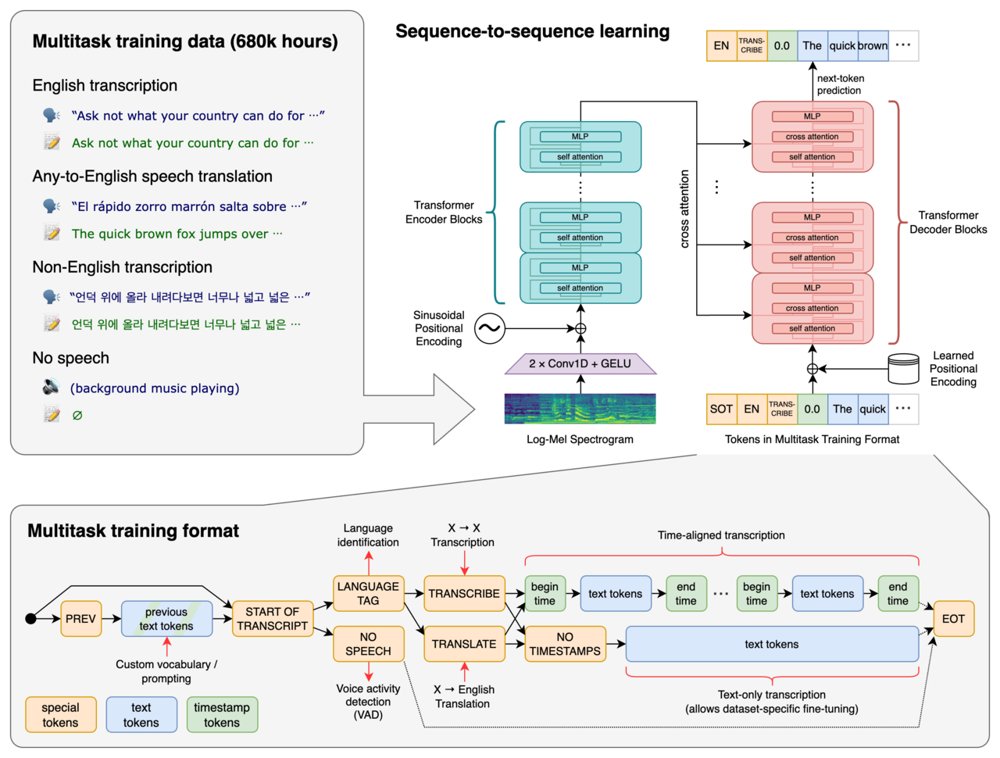
Whisperは、音声を30秒ずつ区切ってメルスペクトログラムという画像のような形に変え、それをエンコーダーで読み取ってから、デコーダーが文字を1つずつ書き出していく仕組みになっている。モデルの大きさは、このエンコーダーとデコーダーの層の数と幅で決まる。OpenAIのリポジトリには、大きさごとのパラメータ数と、動かすのに必要なVRAMの目安、largeを1としたときの相対的な速さが載っている。
| モデル | パラメータ数 | VRAMの目安 | 相対速度 | 英語専用版 |
|---|---|---|---|---|
| tiny | 3,900万 | 約1GB | 約10倍 | あり |
| base | 7,400万 | 約1GB | 約7倍 | あり |
| small | 2億4,400万 | 約2GB | 約4倍 | あり |
| medium | 7億6,900万 | 約5GB | 約2倍 | あり |
| large(v3) | 15億5,000万 | 約10GB | 1倍 | なし |
| turbo(large-v3-turbo) | 8億900万 | 約6GB | 約8倍 | なし |
相対速度は英語の音声をA100というデータセンター向けのGPUで処理したときの値なので、家庭用のGPUや日本語の音声では比率が変わる。それでも、大きさが1段上がるごとに処理時間がおよそ倍になっていく感覚はつかめる。
日本語で使うときに最初に確認しておきたいのは、末尾に「.en」の付いた英語専用版を選ばないことだ。tiny.enやsmall.enは英語に特化して精度を上げた版で、日本語の音声を渡してもまともな結果にはならない。largeとturboにはそもそも英語専用版が無く、多言語版だけが配られている。
largeには世代があり、現行のlarge-v3は2023年11月に公開された。それ以前のlarge-v2と比べると、メルスペクトログラムの周波数の刻みが80から128に増え、学習に使った音声も大きく増えている。具体的には、ラベル付きの音声100万時間に加えて、large-v2で書き起こした音声400万時間を学習に使った。OpenAIが公開している公式のモデルとしては、2024年9月末のlarge-v3-turboがいまのところ最後で、それより新しい世代は出ていない。
日本語の文字誤り率は、smallとmediumのあいだで落ち着く
日本語の精度を見るときは、単語の誤り率(WER)ではなく文字の誤り率(CER)を使う。日本語は単語の区切りに空白を入れないので、単語単位で数えると区切り方の違いまで誤りとして数えられてしまい、数字が実感よりずっと悪く出るためだ。CERは、正解の文字数に対して、置き換え・抜け・余分な挿入がどれだけあったかの割合を表す。
日本語向けにWhisperを改良したkotoba-whisperの配布元が、OpenAIの各モデルを同じ条件で測った表を公開している。テストに使われているのは3種類の音声だ。CommonVoice 8は一般の人が文章を読み上げた録音、JSUTはスタジオで一人の話者が読み上げた音声、ReazonSpeechはテレビ放送から切り出した音声で、背景音や早口が混ざる、いちばん厳しい条件になる。
| モデル | CommonVoice 8 | JSUT | ReazonSpeech |
|---|---|---|---|
| tiny | 53.7% | 36.5% | 137.9% |
| base | 28.6% | 24.9% | 70.4% |
| small | 15.1% | 14.2% | 41.5% |
| medium | 11.5% | 10.0% | 33.2% |
| large(初代) | 10.0% | 8.9% | 34.1% |
| large-v2 | 9.7% | 8.2% | 28.1% |
| large-v3 | 8.5% | 7.1% | 14.9% |
読み上げ音声の2つを見ると、tinyからsmallまでは1段上がるごとに誤り率がほぼ半分になり、smallからmediumで15%前後から10%前後まで下がる。その先のlarge系は、世代を重ねても1〜3ポイントずつしか縮まない。はっきりした読み上げ音声なら、mediumあたりで伸びが緩やかになると見てよさそうだ。
一方、放送音声のReazonSpeechでは様子が違う。tinyの137.9%という値は、誤りが100%を超えている。これは、聞き取れない部分にもっともらしい文章を延々と挿入した結果で、元の文字数より余計な文字のほうが多くなっている。初代largeとlarge-v2でも28〜34%と高く、large-v3でようやく14.9%まで半減する。雑音や早口の混ざる音声では、v3で学習データを増やした効果がいちばん大きく出ている、と読める。打ち合わせの録音は、どちらかといえばこちらの条件に近い。
large-v3-turboは何を削って速くなったのか
large-v3-turboは、large-v3のエンコーダーをそのまま残し、デコーダーの層を32から4に減らしたモデルだ。パラメータ数は15億5,000万から8億900万とほぼ半分になり、相対速度はlargeの約8倍と、tinyに近い速さまで上がっている。音声を読み取るエンコーダーは削らず、文字を書き出すデコーダーだけを軽くしたので、聞き取りの力はできるだけ保ったまま、1文字ずつ書き出す処理の重さを減らした、という設計になっている。
代わりに失ったものもある。turboは書き起こし専用に追加の学習をしたモデルで、翻訳の機能を持たない。翻訳を指定して日本語の音声を渡しても、英訳ではなく日本語のまま返ってくる。日本語を英語の字幕にしたい用途なら、large-v3かmediumを使うことになる。
困るのは、turboの日本語の誤り率が公式には示されていないことだ。OpenAIの説明では、large-v3と比べて精度の低下はわずかで、タイ語や広東語では下がり方が大きいとされているが、日本語の数字は無い。上の表のどこに入るかは、自分の音声で確かめるしかない。
日本語だけを扱うなら、kotoba-whisperという選択肢もある。large-v3のエンコーダーをそのまま使い、デコーダーを2層に縮めて、日本語の放送音声で学習し直したモデルだ。パラメータ数は7億5,600万、速さはlarge-v3の6.3倍とされている。誤り率はCommonVoice 8で9.2%、JSUTで8.4%と、読み上げ音声ではlarge-v3にわずかに届かない。それでも放送音声のReazonSpeechでは11.6%と、large-v3の14.9%を上回る。学習に使ったのと同じ種類の音声に強く出るのは当然とも言えるが、雑談に近い録音を書き起こすなら、試す価値は十分にあると思う。ライセンスはApache-2.0で、商用でも使える。
faster-whisperとwhisper.cpp、同じモデルでも速さとメモリが変わる
同じlarge-v3でも、どの実装で動かすかで速さと使うメモリは大きく変わる。OpenAI本家はPyTorchでそのまま動かす参照用の実装で、いちばん重い。faster-whisperは、CTranslate2という推論専用のエンジンに載せ替えたもので、重みを8bitの整数(int8)に丸めて軽くできる。whisper.cppは、C/C++で書き直した実装で、外部のライブラリに頼らずに動き、MacのMetalやNVIDIAのCUDA、Vulkanなど多くの環境でGPUを使える。
faster-whisperのリポジトリには、13分の音声をlarge-v2で書き起こしたときの比較が載っている。GPUはVRAM 8GBのGeForce RTX 3070 Tiで、ビームサーチの幅はどれも5にそろえてある。
| 実装と設定 | 処理時間 | VRAM | 実時間の何倍速か |
|---|---|---|---|
| OpenAI本家(fp16) | 2分23秒 | 4,708MB | 約5.5倍 |
| whisper.cpp(fp16) | 1分05秒 | 4,127MB | 約12倍 |
| faster-whisper(fp16) | 1分03秒 | 4,525MB | 約12倍 |
| faster-whisper(int8) | 59秒 | 2,926MB | 約13倍 |
| faster-whisper(int8、8本同時) | 16秒 | 4,500MB | 約49倍 |
int8に丸めると、速さはほとんど変わらないまま、VRAMが3GB足らずに収まる。8GBのGPUでも、DAWや配信ソフトと並べて動かす余裕が残る大きさだ。さらに、音声を区切って8本同時に処理するバッチ処理を使うと、13分の音声が16秒で終わる。たまった録音をまとめて書き起こすなら、この設定がいちばん効く。
CPUだけで動かす場合の比較もある。Core i7-12700Kの8スレッドでsmallを動かすと、OpenAI本家が6分58秒かかるのに対して、whisper.cppは2分05秒、faster-whisperのint8は1分42秒で終わる。使うメモリはwhisper.cppが1,049MBと最も少なく、faster-whisperのint8が1,477MBで続く。
whisper.cppはモデルのファイルそのものを小さくできるのも特徴だ。large-v3は元のままだと2.9GiBあるが、5bitに丸めたq5_0なら1.1GiB、turboのq5_0なら547MiBまで縮む。動かすときのメモリの目安は、tinyで約273MB、smallで約852MB、mediumで約2.1GB、largeで約3.9GBとされている。Apple Siliconの場合はCPUとGPUがメモリを共有するので、このくらいの大きさならVRAMの上限を気にせずlarge-v3まで載せられる。faster-whisperはMacではGPUを使えないので、Macではwhisper.cppを選ぶのが素直だと思う。
日本語で起きやすい誤認識と、その対策
モデルを大きくしても消えない誤りの傾向がいくつかある。いちばん目立つのは、無音や音楽だけの区間に、話されていない文章を書き足してしまう現象だ。動画の締めの決まり文句のような、学習データに多かったと思われる文章がそのまま出てくることがある。ReazonSpeechのtinyで誤り率が100%を超えていたのも、同じ現象が極端に出た例だ。
もう一つは、同じ文が何十回も繰り返される暴走だ。Whisperは、直前の30秒で書き起こした文章を次の区間の手がかりとして渡す設定が初期値で有効になっている。前の区間で一度繰り返しが始まると、それが次の区間に引き継がれて止まらなくなる。OpenAI本家なら condition_on_previous_text を False にすると、区間をまたいだ文のつながりは少し不自然になるが、暴走にはまりにくくなる。
どちらにも効くのが、話していない区間を先に取り除いておく処理だ。faster-whisperは vad_filter=True を指定すると、Silero VADという音声区間の検出器で無音部分を落としてから書き起こす。whisper.cppにも同じ検出器を使う機能が入っている。打ち合わせの録音のように、沈黙や物音の多い音声では、モデルを1段大きくするより先にこちらを試したほうが効果が分かりやすい。
日本語ならではの細かい点もある。OpenAI本家は初期設定で、話し声ではない記号として一部の文字を出力しないようにしている。その一覧に「」と『』が含まれているので、会話の引用やタイトルを示すかぎかっこは書き起こしに出てこない。句読点の打ち方も一定せず、読点がほとんど入らないこともある。また、機材名や人名のような固有名詞は、initial_prompt に正しい表記を含んだ短い文章を渡しておくと、その表記に寄せて書き起こされやすくなる。
自分の環境での組み合わせと、確かめる手順
ここまでの数字から、環境ごとの出発点をまとめておく。NVIDIAのGPUでVRAMが8GB以上あるなら、faster-whisperのint8でlarge-v3を動かすのが基準になる。3GB足らずで動き、放送音声でも誤り率が15%前後に収まる。速さを優先するならturboかkotoba-whisperに替えて、誤りがどれだけ増えるかを比べる。VRAMが4GB前後なら、faster-whisperのint8でturboを使うか、mediumに下げる。
Macなら、whisper.cppのMetal対応でlarge-v3かturboを使う。CPUだけのノートPCなら、whisper.cppかfaster-whisperのint8でsmallを使い、時間に余裕があるときだけmediumに上げる。tinyとbaseは、日本語では誤り率が25〜50%にもなるので、書き起こしの下書きとしても使いにくい。
公表されている数字は、条件をそろえた比較には向いているが、自分の録音での結果を約束するものではない。確かめるときは、次の順番で進めると判断がしやすい。
- 自分の録音から、話し声がはっきりした部分と、雑音や沈黙の多い部分を5分ずつ切り出し、正しい書き起こしを手で作っておく。
- 同じ実装・同じ設定で、medium、large-v3、turboの3つを回し、処理時間と、タスクマネージャーで見たVRAMの最大値を控える。
- 正解と並べて、固有名詞の取り違え、文の抜け、存在しない文の挿入の3種類に分けて数える。
誤り率の数字だけでなく、どの種類の誤りが多いかを見ておくと、モデルを替えるべきか、VADや initial_prompt で対処すべきかがはっきりする。挿入が多いならVADを、固有名詞の取り違えが多いならプロンプトを、全体に誤りが多いならモデルを1段大きくする、という順番で手を入れていけば、遠回りせずに済むと思う。